
Tot pla de projecte es recolza en un munt de petites apostes: aquest tiquet són dues hores, aquell és un dia. Les persones som notòriament dolentes fent aquestes apostes. Kahneman i Tversky ho van batejar el 1979 com a fal·làcia de la planificació: ens ancorem en el millor escenari i oblidem quant vam trigar l'última vegada en una cosa semblant.
La solució òbvia és preguntar-ho a una IA. Però un model de llenguatge gran no ha vist mai el teu equip, els teus clients ni el teu codi, així que qualsevol número que et doni és una suposició ben redactada. La informació que de debò prediu quant trigarà la teva propera tasca ja és als teus fulls d'hores: milers de tasques acabades, cadascuna amb les hores que algú hi va dedicar realment.
Per això vam construir l'estimació d'esforç de Monton al revés. En lloc d'un model que genera una resposta, recupera la feina més semblant que la teva organització ja ha fet i deixa que aquest historial voti. Per dins és un mètode no paramètric clàssic, la regressió pels k veïns més propers (kNN), que funciona sobre embeddings de text moderns.
Claus:
- Aprèn només de les teves dades. Les estimacions surten de les teves pròpies tasques acabades i hores imputades, mai de les d'altres empreses.
- No té fase d'entrenament. kNN és un aprenent mandrós (lazy learner): cada tasca que acabes es converteix a l'instant en una dada nova.
- És explicable. Cada estimació ve amb les tasques semblants que l'han produïda, perquè vegis per què.
- És gairebé tan bona com l'equip i cobreix el que l'equip no estima. A Bewise va igualar la precisió humana en les tasques que algú va estimar i va donar un número per al 60 % de les tasques que ningú no va estimar.
1. El problema, formalment
Cada tasca acabada d'una organització té una descripció en text i un valor objectiu , el total d'hores imputades:
on és el conjunt d'imputacions de temps de la tasca i la durada de cadascuna. Això ens dona un historial etiquetat
i la tasca és un problema de regressió supervisada: donat el text d'una tasca nova , predir .
Dues propietats d'aquestes dades condicionen tota la resta. Primer, és petit per als estàndards de l'aprenentatge automàtic: d'uns quants centenars a uns quants milers de tasques per organització, massa poques per fer fine-tuning d'un model per client. Segon, té cua pesant: la majoria de tasques porten d'una a quatre hores, però unes quantes en porten quaranta. Totes dues coses empenyen cap a un mètode que no necessiti entrenament i sigui robust als valors atípics.
2. Del text als vectors: embeddings
Un kNN necessita una noció de distància, i les distàncies necessiten vectors. Portem cada tasca a un punt de amb una funció d'embedding .
El text que convertim segueix una plantilla fixa construïda amb els camps de la mateixa tasca:
query: <nom de la tasca> (<projecte> / <fase> / <tipus>) . <descripció>
S'eliminen prefixos de tiquet com TASK-625: (no aporten informació sobre l'esforç), l'HTML de l'editor es redueix a text pla i la descripció es limita a 1.200 caràcters.
El codificador és multilingual-e5-small, un transformer de 12 capes entrenat amb aprenentatge contrastiu perquè textos amb significat semblant quedin a prop, en qualsevol d'uns 100 idiomes. Això importa als equips que escriuen tiquets en català, castellà i anglès la mateixa setmana. El codificador produeix un vector contextual per a cadascun dels tokens; en fem el mean pooling (la mitjana) i normalitzem amb L2 el resultat:
Després de la normalització, cada tasca viu a la hiperesfera unitat . Executem el model com un graf ONNX quantitzat a int8 dins dels nostres propis servidors: desenes de mil·lisegons per tasca un cop carregat, i el text de les teves tasques no va mai a una API d'IA externa.
Cada vector es desa al costat de la tasca a Postgres amb pgvector, amb un hash SHA-256 del text exacte i del model, de manera que una tasca només es torna a convertir quan el seu text canvia de debò.
3. Similitud: el cosinus sobre l'esfera unitat
La similitud entre la tasca nova i una tasca acabada és la similitud del cosinus:
L'últim pas és el motiu de normalitzar: amb vectors unitaris, la similitud del cosinus és un simple producte escalar, i es relaciona directament amb la distància euclidiana mitjançant . Ordenar per més similitud i ordenar per menys distància és el mateix.
4. El veïnat
El conjunt de candidates són totes les tasques de l'organització que estan acabades, no arxivades, convertides en vector i amb hores imputades més grans que zero. La tasca actual queda exclosa, així que una tasca no es pot "estimar a si mateixa" mai. D'aquest conjunt ens quedem amb les més semblants:
Fem expressament una cerca exacta en lloc de fer servir un índex de veïns més propers aproximat (ANN) com HNSW. El conjunt es filtra per organització i, amb cerca ANN filtrada, a una organització petita li poden sobreviure molt poques candidates al filtre, cosa que degrada el recall sense avisar. Les dades de cada organització són prou petites perquè la cerca exacta continuï sent ràpida, i sempre és exactament correcta.
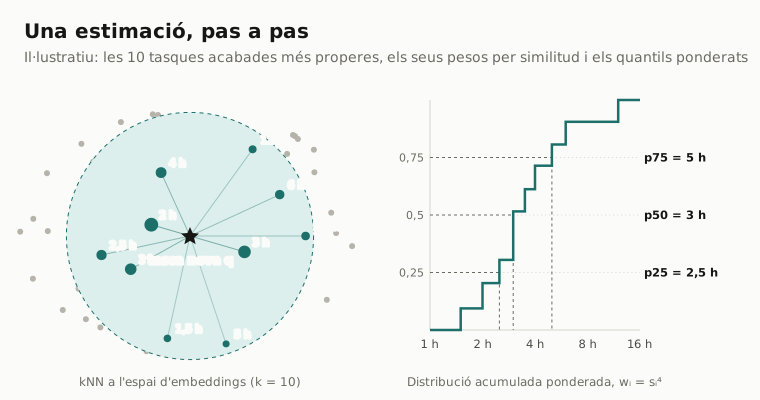
5. Ponderació: els veïns més propers voten més fort
Un kNN simple dona a cada veí el mateix vot. Nosaltres ponderem cada veí amb una potència de la seva similitud:
L'exponent existeix per una propietat coneguda dels embeddings e5: les similituds estan comprimides en una franja estreta, aproximadament entre 0,75 i 1. Amb les dades de Bewise, la coincidència més propera d'una tasca té una similitud mediana de 0,937; una quarta part de les tasques no en té cap per sobre de 0,923, i una de cada deu cap per sobre de 0,913. Les similituds en aquesta franja gairebé no es diferencien, així que elevar-les a la quarta potència estira el contrast: un veí amb 0,96 rep un pes de 0,849 i un amb 0,92, de 0,716, de manera que la proporció entre ells passa d'1,04 a 1,19. És un esmolat suau, una versió tova de la temperatura d'un softmax, que afavoreix les coincidències més properes sense deixar que una de sola decideixi.
6. L'estimació: quantils ponderats, no una mitjana
El regressor kNN ingenu és la mitjana ponderada, . Amb hores de cua pesant això és fràgil: una tasca de quaranta hores entre nou de dues hores arrossega la mitjana fins a gairebé sis hores. Per això fem servir quantils ponderats.
Ordenem els veïns per hores i construïm la funció de distribució acumulada empírica ponderada:
El quantil és el valor observat més petit en què el pes acumulat arriba a :
Monton en retorna tres. La mediana ponderada és l'estimació puntual; i formen un interval interquartílic que indica quant ha variat la feina semblant.
La mediana no és una elecció arbitrària. És el valor que minimitza l'error absolut ponderat i, en general, cada quantil minimitza la pèrdua pinball que es fa servir en la regressió quantílica:
Amb , : l'estimació és òptima sota error absolut, que tracta un error de tres hores com un error de tres hores en lloc d'elevar-lo al quadrat, i ignora el monstre ocasional de quaranta hores.
7. Saber quan no refiar-se'n
Dues salvaguardes mantenen honesta l'estimació:
- Arrencada en fred. Per sota de tasques acabades amb hores imputades no hi ha estimació. El diàleg de la tasca mostra en el seu lloc un comptador de progrés ("12/20").
- Baixa confiança. Si fins i tot el veí més proper és lluny, , l'estimació es marca com de baixa confiança. El llindar és aproximadament al quartil inferior de la similitud de la coincidència més propera en dades reals: en aquests casos la teva organització simplement no ha fet mai res semblant, i el número s'ha de llegir com una referència aproximada.
Què veus a Monton
Al diàleg de la tasca, sota Esforç, Monton mostra l'estimació IA com la mediana i el rang p25–p75, llista les tasques acabades semblants en què es basa amb les hores imputades i la similitud, i ofereix un botó Fer servir X h per aplicar-la amb un clic. El mateix estimador està disponible per als assistents d'IA a través del servidor MCP de Monton, així que pots demanar a Claude que estimi una llista sencera de tasques mentre prepares una proposta.
8. Cas d'èxit: Bewise
Bewise és una empresa de desenvolupament de programari que gestiona els seus projectes, les hores i l'assignació de l'equip a Monton, així que era el primer conjunt de dades natural. Quan vam fer l'anàlisi tenia 5.090 tasques acabades amb 31.178 hores imputades.
A què es dedica realment l'equip
Abans d'estimar res, els mateixos embeddings responen una pregunta més senzilla: quin tipus de feina omple les hores? El nou informe Anàlisi de tasques de Monton agrupa els vectors de les tasques en temes. Aquí importa un detall tècnic. Com que el nom del projecte forma part del text convertit, els grups en brut agrupen les tasques per projecte i no per activitat. Ho corregim centrant cada vector en el seu projecte, restant una mitjana del projecte amb contracció (shrinkage):
on és el projecte de la tasca i el seu nombre de tasques. El factor de contracció evita que els projectes petits es centrin en una mitjana sorollosa. Després executem k-means, que minimitza la suma de quadrats dins de cada grup
un model de llenguatge proposa una taxonomia de categories d'una sola activitat i posa nom a cada grup, i el mapa es dibuixa amb escalat multidimensional (MDS) clàssic dels centroides, de manera que els temes propers al mapa són semànticament propers a l'espai d'embeddings.
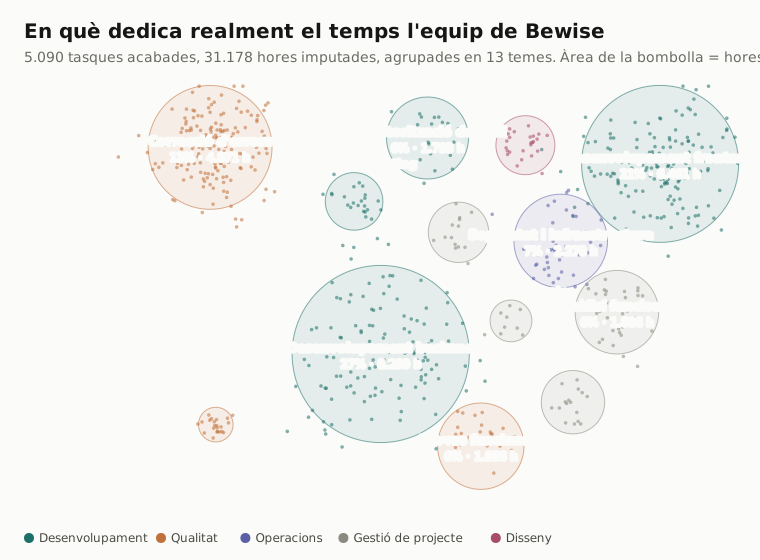
Com era d'esperar, domina el desenvolupament, però el mapa també mostra que només la correcció d'errors suposa el 13 % de totes les hores, més que l'anàlisi funcional, la documentació i les reunions juntes.
Per què un rang i no un sol número
El mateix informe mostra quant varia l'esforç dins de cada tema. Les caixes d'aquí sota són els rangs interquartílics d'hores imputades per tasca:
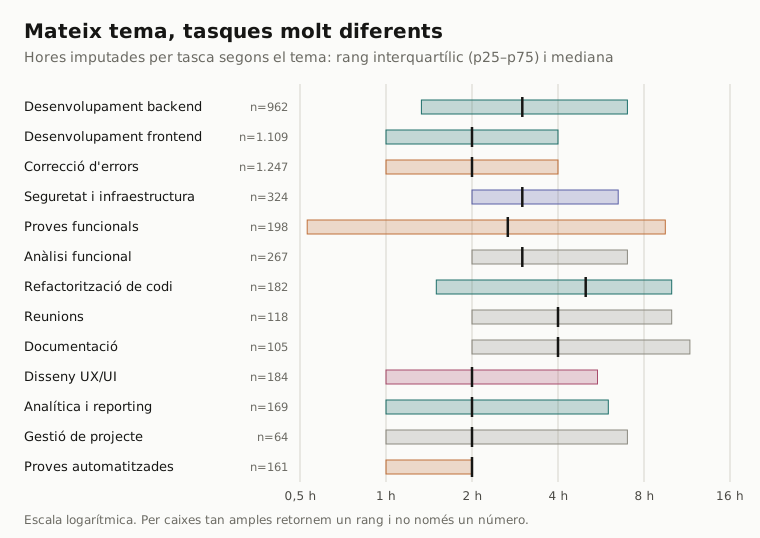
Les proves funcionals tenen una mediana de 2,7 hores, però una quarta part d'aquestes tasques en porta més de 9,5. Qualsevol mètode que retorni un sol número per a "una tasca de proves" s'equivocarà la majoria de vegades. kNN treballa un nivell per sota del tema, amb les deu tasques individuals més semblants, i tot i així informa de la dispersió perquè vegis quan l'historial és sorollós.
Precisió davant de l'equip
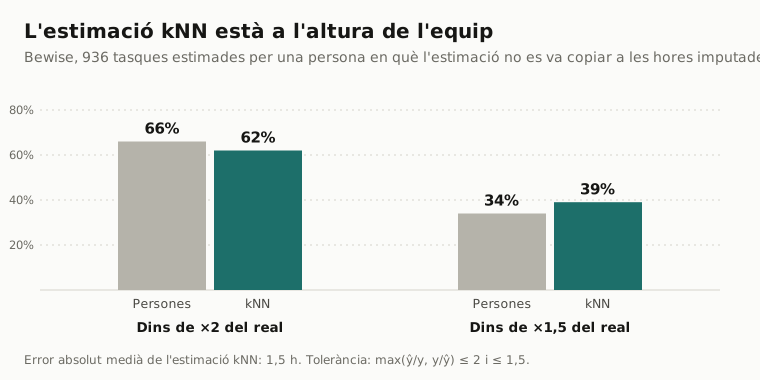
Comparar amb estimacions humanes té trampa. De les tasques que tenien una estimació humana, 1.077 van imputar exactament les hores estimades: l'estimació es va copiar al full d'hores, així que semblaria perfecta. Les excloem i comparem sobre les 936 tasques en què una persona va estimar i les hores imputades són diferents. Cada tasca s'estima deixant-la fora (leave-one-out), a partir de totes les altres tasques acabades, exactament com fa el sistema en producció.
Comptem un encert quan l'estimació és dins d'un factor de la realitat, cosa que tracta igual la sobreestimació i la infraestimació:
| Bewise, tasques acabades | Tasques | Persones dins de ×2 | kNN dins de ×2 |
|---|---|---|---|
| Estimades de debò per una persona | 936 | 66 % | 62 % |
| … d'aquestes, tasques | 877 | 66 % | 62 % |
| … d'aquestes, errors | 53 | 62 % | 62 % |
| Estimació copiada al full d'hores | 1.077 | excloses | excloses |
| Mai estimades per ningú | 3.077 | sense estimació | estimades |
Els números es llegeixen de tres maneres:
- A la mateixa lliga que l'equip. Amb la tolerància habitual de ×2, el kNN queda quatre punts per darrere de les persones que coneixen la feina, sense dedicar-hi temps humà.
- Més fina quan l'encerta. Amb ×1,5 supera l'equip, 39 % davant de 34 %. L'error absolut medià és d'1,5 hores.
- Cobreix el punt cec. 3.077 de les 5.090 tasques, el 60 %, no havien tingut mai estimació. Per planificar la capacitat són les tasques que fan mal, i ara reben un número basat en dades.
Una precisió baixa en una tasca concreta tampoc no és sempre un error. L'informe llista les tasques que van portar com a mínim el triple que les seves veïnes més properes (524 a Bewise), o un terç o menys (473). Aquests valors atípics són on va créixer l'abast, un tiquet es va fer servir de calaix de sastre o un problema va resultar més difícil del que semblava: just les tasques que hauria de mirar una retrospectiva.
9. Per què kNN i no un model més gran?
Fer fine-tuning d'un regressor neuronal per client, o demanar un número a un model de llenguatge gran, eren opcions sobre la taula. kNN va guanyar per propietats que importen més que uns quants punts de precisió en un benchmark:
- Es construeix amb les dades de la teva organització, i només amb aquestes. El model d'embeddings és d'ús general: només sap que "fix login redirect" i "corregir la redirecció del login" volen dir una cosa semblant. Tot el que decideix el número, el teu stack, els teus clients, la velocitat del teu equip i com divideixes la feina en tasques, surt del teu propi historial. Les estimacions d'una agència que fa webs amb WordPress i les d'una que construeix backends bancaris seran diferents, com ha de ser.
- Sense pipeline d'entrenament, sense deriva. No hi ha pesos per ajustar per client ni calendari de reentrenament. Tan bon punt una tasca es marca com a acabada amb hores imputades, forma part del model. La regressió pels veïns més propers és un estimador consistent molt estudiat (Stone, 1977): com més historial té, més propers són els veïns que troba, així que les estimacions tendeixen a millorar soles amb l'ús.
- Explicable per construcció. L'estimació d'una xarxa neuronal és funció de milions de paràmetres. La d'un kNN és funció de deu tasques on pots fer clic. Si el suggeriment sembla incorrecte, la llista de veïns sol mostrar el perquè en pocs segons.
- Privadesa i aïllament. La cerca s'executa dins de la base de dades amb els permisos de qui la demana, i la seguretat a nivell de fila limita cada consulta a una sola organització. Cap tasca d'una altra empresa no pot ser mai veïna de les teves, i el model d'embeddings s'executa a la nostra pròpia infraestructura.
- Incertesa calibrada sense cost extra. Com que el resultat és una distribució i no un punt, el rang p25–p75 surt de franc i s'eixampla quan el teu historial és inconsistent.
- Un cercle virtuós. Les estimacions són tan bones com les hores imputades. Els equips que registren el temps amb cura obtenen estimacions més fines, que milloren la planificació, cosa que fa que valgui la pena mantenir el full d'hores al dia.
10. Limitacions
El mètode hereta les manies de les seves dades. Si les tasques es diuen "Desenvolupament" sense descripció, hi ha poc text per comparar. Si les hores s'imputen a la tasca equivocada, els veïns arrosseguen l'error. Els tipus de feina totalment nous no tenen veïns, que és justament el que t'indica la marca de baixa confiança. I kNN estima quant va trigar la feina semblant, no quant hauria de trigar: si un equip és sistemàticament lent en alguna cosa, l'estimació ho reproduirà fidelment.
Conclusió
Estimar bé no necessita un model que ho sàpiga tot. En necessita un que conegui la teva feina. Combinant un codificador multilingüe compacte amb una de les idees més antigues de l'aprenentatge automàtic, els veïns més propers, Monton converteix les hores que ja imputes en estimacions explicables, privades i que milloren cada vegada que s'acaba una tasca. En el cas de Bewise, això va suposar estimacions a l'altura de les del mateix equip, i un número per al 60 % de les tasques que no n'havien tingut mai.
Referències: D. Kahneman i A. Tversky, "Intuitive prediction: biases and corrective procedures" (1979). T. Cover i P. Hart, "Nearest neighbor pattern classification", IEEE Transactions on Information Theory (1967). C. J. Stone, "Consistent nonparametric regression", The Annals of Statistics (1977). L. Wang et al., "Multilingual E5 text embeddings: a technical report" (2024). R. Koenker i G. Bassett, "Regression quantiles", Econometrica (1978).
Preguntes freqüents
- Com estima la IA de Monton l'esforç d'una tasca?
- Converteix el nom, el projecte, la fase, el tipus i la descripció de la tasca en un vector de 384 dimensions amb un model d'embeddings multilingüe, busca les 10 tasques acabades més semblants de la teva organització i retorna la mediana ponderada per similitud de les hores imputades en aquestes tasques, juntament amb el rang entre els percentils 25 i 75.
- El model s'entrena amb dades d'altres empreses?
- No. El model d'embeddings és un model de llenguatge d'ús general que només converteix text en vectors. L'estimació surt exclusivament de les tasques acabades i les hores imputades de la teva organització, i la seguretat a nivell de fila manté separades les dades de cada organització.
- Quantes tasques necessito perquè apareguin estimacions?
- Com a mínim 20 tasques acabades amb hores imputades. Per sota d'aquesta xifra, Monton mostra un comptador de progrés en lloc d'un número. Les estimacions guanyen fiabilitat a mesura que s'acaben més tasques, sense cap pas de reentrenament.
- Quina precisió té?
- A Bewise, sobre 936 tasques amb una estimació humana real, l'estimació kNN va quedar a menys del doble de les hores reals el 62 % de les vegades, davant del 66 % de l'equip, i va ser més precisa que l'equip amb la tolerància més estricta de ×1,5 (39 % davant de 34 %). A més, dona una estimació per al 60 % de les tasques que ningú no va estimar.
- S'envia el text de les meves tasques a un proveïdor extern d'IA?
- No. El model d'embeddings s'executa dins dels servidors de Monton, de manera que el text de les teves tasques no s'envia a cap API d'IA de tercers per calcular les estimacions.