
Todo plan de proyecto se apoya en un montón de pequeñas apuestas: este ticket son dos horas, aquel es un día. Las personas somos notoriamente malas haciendo esas apuestas. Kahneman y Tversky lo bautizaron en 1979 como falacia de la planificación: nos anclamos en el mejor escenario y olvidamos cuánto tardamos la última vez en algo parecido.
La solución obvia es preguntarle a una IA. Pero un modelo de lenguaje grande nunca ha visto a tu equipo, a tus clientes ni tu código, así que cualquier número que te dé es una suposición bien redactada. La información que de verdad predice cuánto va a tardar tu próxima tarea ya está en tus partes de horas: miles de tareas terminadas, cada una con las horas que alguien dedicó realmente.
Por eso construimos la estimación de esfuerzo de Monton al revés. En lugar de un modelo que genera una respuesta, recupera el trabajo más parecido que tu organización ya ha hecho y deja que ese historial vote. Por dentro es un método no paramétrico clásico, la regresión por k vecinos más cercanos (kNN), que funciona sobre embeddings de texto modernos.
Claves:
- Aprende solo de tus datos. Las estimaciones salen de tus propias tareas terminadas y horas imputadas, nunca de las de otras empresas.
- No tiene fase de entrenamiento. kNN es un aprendiz perezoso (lazy learner): cada tarea que terminas se convierte al instante en un nuevo dato.
- Es explicable. Cada estimación viene con las tareas parecidas que la produjeron, para que veas por qué.
- Es casi tan buena como el equipo y cubre lo que el equipo no estima. En Bewise igualó la precisión humana en las tareas que alguien estimó y dio un número para el 60 % de las tareas que nadie estimó.
1. El problema, formalmente
Cada tarea terminada de una organización tiene una descripción en texto y un valor objetivo , el total de horas imputadas en ella:
donde es el conjunto de imputaciones de tiempo de la tarea y la duración de cada una. Eso nos da un historial etiquetado
y la tarea es un problema de regresión supervisada: dado el texto de una tarea nueva , predecir .
Dos propiedades de estos datos condicionan todo lo demás. Primero, es pequeño para los estándares del aprendizaje automático: de unos cientos a unos miles de tareas por organización, demasiado pocas para hacer fine-tuning de un modelo por cliente. Segundo, tiene cola pesada: la mayoría de tareas llevan de una a cuatro horas, pero unas pocas llevan cuarenta. Las dos cosas empujan hacia un método que no necesite entrenamiento y sea robusto a los valores atípicos.
2. Del texto a los vectores: embeddings
Un kNN necesita una noción de distancia, y las distancias necesitan vectores. Llevamos cada tarea a un punto de con una función de embedding .
El texto que convertimos sigue una plantilla fija construida con los campos de la propia tarea:
query: <nombre de la tarea> (<proyecto> / <fase> / <tipo>) . <descripción>
Se eliminan prefijos de ticket como TASK-625: (no aportan información sobre el esfuerzo), el HTML del editor se reduce a texto plano y la descripción se limita a 1.200 caracteres.
El codificador es multilingual-e5-small, un transformer de 12 capas entrenado con aprendizaje contrastivo para que textos con significado parecido queden cerca, en cualquiera de unos 100 idiomas. Eso importa a los equipos que escriben tickets en español, inglés y catalán en la misma semana. El codificador produce un vector contextual para cada uno de los tokens; hacemos mean pooling (la media) y normalizamos con L2 el resultado:
Tras la normalización, cada tarea vive en la hiperesfera unidad . Ejecutamos el modelo como un grafo ONNX cuantizado a int8 dentro de nuestros propios servidores: decenas de milisegundos por tarea una vez cargado, y el texto de tus tareas nunca va a una API de IA externa.
Cada vector se guarda junto a la tarea en Postgres con pgvector, con un hash SHA-256 del texto exacto y del modelo, de modo que una tarea solo se vuelve a convertir cuando su texto cambia de verdad.
3. Similitud: el coseno sobre la esfera unidad
La similitud entre la tarea nueva y una tarea terminada es la similitud del coseno:
El último paso es el motivo de normalizar: con vectores unitarios, la similitud del coseno es un simple producto escalar, y se relaciona directamente con la distancia euclídea mediante . Ordenar por mayor similitud y ordenar por menor distancia es lo mismo.
4. El vecindario
El conjunto de candidatas son todas las tareas de la organización que están terminadas, no archivadas, convertidas en vector y con horas imputadas mayores que cero. La tarea actual queda excluida, así que una tarea nunca puede "estimarse a sí misma". De ese conjunto nos quedamos con las más parecidas:
Hacemos a propósito una búsqueda exacta en lugar de usar un índice de vecinos más cercanos aproximado (ANN) como HNSW. El conjunto se filtra por organización y, con búsqueda ANN filtrada, a una organización pequeña le pueden sobrevivir muy pocas candidatas al filtro, lo que degrada el recall sin avisar. Los datos de cada organización son lo bastante pequeños como para que la búsqueda exacta siga siendo rápida, y siempre es exactamente correcta.
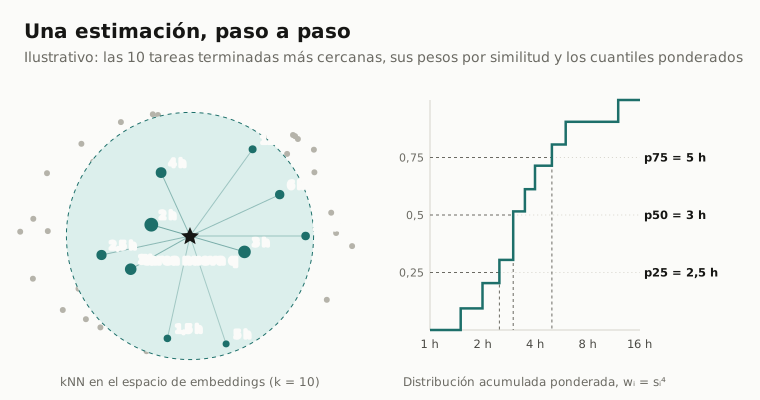
5. Ponderación: los vecinos más cercanos votan más fuerte
Un kNN simple da a cada vecino el mismo voto. Nosotros ponderamos cada vecino con una potencia de su similitud:
El exponente existe por una propiedad conocida de los embeddings e5: las similitudes están comprimidas en una franja estrecha, aproximadamente entre 0,75 y 1. Con los datos de Bewise, la coincidencia más cercana de una tarea tiene una similitud mediana de 0,937; una cuarta parte de las tareas no tiene ninguna por encima de 0,923, y una de cada diez ninguna por encima de 0,913. Las similitudes en esa franja apenas se diferencian, así que elevarlas a la cuarta potencia estira el contraste: un vecino con 0,96 recibe un peso de 0,849 y uno con 0,92, de 0,716, de modo que la proporción entre ellos pasa de 1,04 a 1,19. Es un afilado suave, una versión blanda de la temperatura de un softmax, que favorece a las coincidencias más cercanas sin dejar que una sola decida.
6. La estimación: cuantiles ponderados, no una media
El regresor kNN ingenuo es la media ponderada, . Con horas de cola pesada eso es frágil: una tarea de cuarenta horas entre nueve de dos horas arrastra la media hasta casi seis horas. Por eso usamos cuantiles ponderados.
Ordenamos los vecinos por horas y construimos la función de distribución acumulada empírica ponderada:
El cuantil es el menor valor observado en el que el peso acumulado alcanza :
Monton devuelve tres. La mediana ponderada es la estimación puntual; y forman un intervalo intercuartílico que indica cuánto ha variado el trabajo parecido.
La mediana no es una elección arbitraria. Es el valor que minimiza el error absoluto ponderado y, en general, cada cuantil minimiza la pérdida pinball que se usa en la regresión cuantílica:
Con , : la estimación es óptima bajo error absoluto, que trata un fallo de tres horas como un fallo de tres horas en lugar de elevarlo al cuadrado, e ignora el monstruo ocasional de cuarenta horas.
7. Saber cuándo no fiarse
Dos salvaguardas mantienen honesta la estimación:
- Arranque en frío. Por debajo de tareas terminadas con horas imputadas no hay estimación. El diálogo de la tarea muestra en su lugar un contador de progreso ("12/20").
- Baja confianza. Si incluso el vecino más cercano está lejos, , la estimación se marca como de baja confianza. El umbral está aproximadamente en el cuartil inferior de la similitud de la coincidencia más cercana en datos reales: en esos casos tu organización simplemente no ha hecho nada parecido antes, y el número debe leerse como una referencia aproximada.
Lo que ves en Monton
En el diálogo de la tarea, bajo Esfuerzo, Monton muestra la estimación IA como la mediana y el rango p25–p75, lista las tareas terminadas parecidas en las que se basa con sus horas imputadas y su similitud, y ofrece un botón Usar X h para aplicarla con un clic. El mismo estimador está disponible para asistentes de IA a través del servidor MCP de Monton, así que puedes pedirle a Claude que estime una lista entera de tareas mientras preparas una propuesta.
8. Caso de éxito: Bewise
Bewise es una empresa de desarrollo de software que gestiona sus proyectos, sus horas y la asignación de su equipo en Monton, así que era el primer conjunto de datos natural. Cuando hicimos el análisis tenía 5.090 tareas terminadas con 31.178 horas imputadas.
A qué se dedica realmente el equipo
Antes de estimar nada, los mismos embeddings responden a una pregunta más sencilla: ¿qué tipo de trabajo llena las horas? El nuevo informe Análisis de tareas de Monton agrupa los vectores de las tareas en temas. Aquí importa un detalle técnico. Como el nombre del proyecto forma parte del texto convertido, los grupos en bruto agrupan las tareas por proyecto y no por actividad. Lo corregimos centrando cada vector en su proyecto, restando una media del proyecto con contracción (shrinkage):
donde es el proyecto de la tarea y su número de tareas. El factor de contracción evita que los proyectos pequeños se centren en una media ruidosa. Después ejecutamos k-means, que minimiza la suma de cuadrados dentro de cada grupo
un modelo de lenguaje propone una taxonomía de categorías de una sola actividad y pone nombre a cada grupo, y el mapa se dibuja con escalado multidimensional (MDS) clásico de los centroides, de modo que los temas cercanos en el mapa son semánticamente cercanos en el espacio de embeddings.
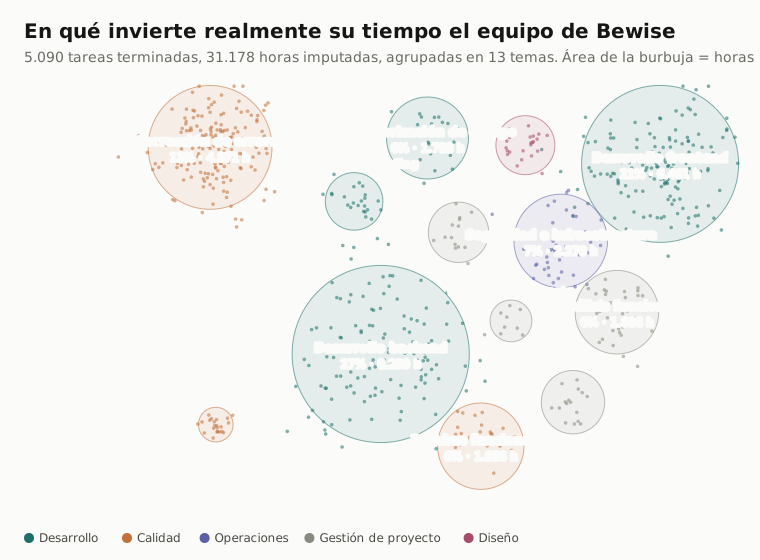
Como era de esperar, domina el desarrollo, pero el mapa también muestra que solo la corrección de errores supone el 13 % de todas las horas, más que el análisis funcional, la documentación y las reuniones juntos.
Por qué un rango y no un único número
El mismo informe muestra cuánto varía el esfuerzo dentro de cada tema. Las cajas de abajo son los rangos intercuartílicos de horas imputadas por tarea:
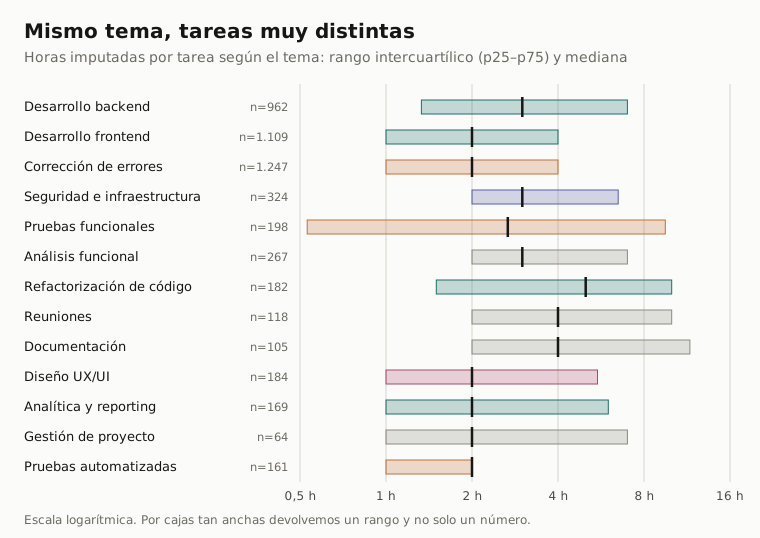
Las pruebas funcionales tienen una mediana de 2,7 horas, pero una cuarta parte de esas tareas lleva más de 9,5. Cualquier método que devuelva un único número para "una tarea de pruebas" se equivocará la mayoría de las veces. kNN trabaja un nivel por debajo del tema, con las diez tareas individuales más parecidas, y aun así informa de la dispersión para que veas cuándo el historial es ruidoso.
Precisión frente al equipo
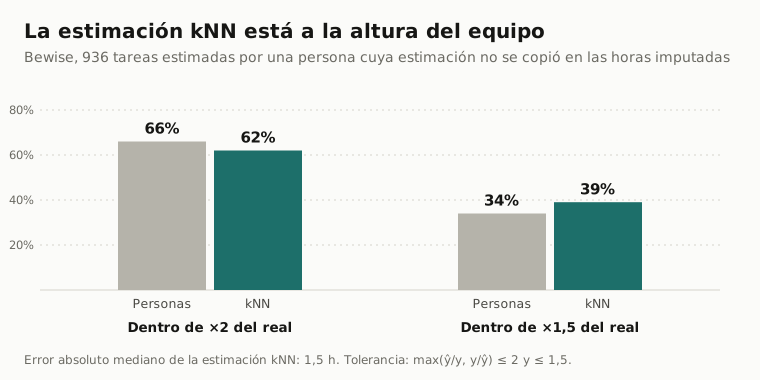
Comparar con estimaciones humanas tiene trampa. De las tareas que tenían una estimación humana, 1.077 imputaron exactamente las horas estimadas: la estimación se copió en el parte de horas, así que parecería perfecta. Las excluimos y comparamos sobre las 936 tareas en las que una persona estimó y las horas imputadas son distintas. Cada tarea se estima dejándola fuera (leave-one-out), a partir de todas las demás tareas terminadas, exactamente como hace el sistema en producción.
Contamos un acierto cuando la estimación está dentro de un factor de la realidad, lo que trata por igual la sobreestimación y la infraestimación:
| Bewise, tareas terminadas | Tareas | Personas dentro de ×2 | kNN dentro de ×2 |
|---|---|---|---|
| Estimadas de verdad por una persona | 936 | 66 % | 62 % |
| … de ellas, tareas | 877 | 66 % | 62 % |
| … de ellas, bugs | 53 | 62 % | 62 % |
| Estimación copiada en el parte de horas | 1.077 | excluidas | excluidas |
| Nunca estimadas por nadie | 3.077 | sin estimación | estimadas |
Los números se leen de tres maneras:
- En la misma liga que el equipo. Con la tolerancia habitual de ×2, el kNN queda cuatro puntos por detrás de las personas que conocen el trabajo, sin dedicarle tiempo humano.
- Más fina cuando acierta. Con ×1,5 supera al equipo, 39 % frente a 34 %. El error absoluto mediano es de 1,5 horas.
- Cubre el punto ciego. 3.077 de las 5.090 tareas, el 60 %, nunca tuvieron estimación. Para planificar la capacidad son las tareas que hacen daño, y ahora reciben un número respaldado por datos.
Una baja precisión en una tarea concreta tampoco es siempre un fallo. El informe lista las tareas que llevaron al menos el triple que sus vecinas más cercanas (524 en Bewise), o un tercio o menos (473). Esos valores atípicos son donde creció el alcance, un ticket se usó como cajón de sastre o un problema resultó más difícil de lo que parecía: justo las tareas que debería mirar una retrospectiva.
9. ¿Por qué kNN y no un modelo más grande?
Hacer fine-tuning de un regresor neuronal por cliente, o pedirle un número a un modelo de lenguaje grande, eran opciones sobre la mesa. kNN ganó por propiedades que importan más que unos puntos de precisión en un benchmark:
- Se construye con los datos de tu organización, y solo con ellos. El modelo de embeddings es de uso general: solo sabe que "fix login redirect" y "corregir redirección del login" significan algo parecido. Todo lo que decide el número, tu stack, tus clientes, la velocidad de tu equipo y cómo divides el trabajo en tareas, sale de tu propio historial. Las estimaciones de una agencia que hace webs en WordPress y las de una que construye backends bancarios serán distintas, como debe ser.
- Sin pipeline de entrenamiento, sin deriva. No hay pesos que ajustar por cliente ni calendario de reentrenamiento. En cuanto una tarea se marca como terminada con horas imputadas, forma parte del modelo. La regresión por vecinos más cercanos es un estimador consistente muy estudiado (Stone, 1977): cuanto más historial tiene, más cercanos son los vecinos que encuentra, así que las estimaciones tienden a mejorar solas con el uso.
- Explicable por construcción. La estimación de una red neuronal es función de millones de parámetros. La de un kNN es función de diez tareas en las que puedes hacer clic. Si la sugerencia parece incorrecta, la lista de vecinos suele mostrar el porqué en unos segundos.
- Privacidad y aislamiento. La búsqueda se ejecuta dentro de la base de datos con los permisos de quien la pide, y la seguridad a nivel de fila limita cada consulta a una sola organización. Ninguna tarea de otra empresa puede ser nunca vecina de las tuyas, y el modelo de embeddings se ejecuta en nuestra propia infraestructura.
- Incertidumbre calibrada sin coste extra. Como el resultado es una distribución y no un punto, el rango p25–p75 sale gratis y se ensancha cuando tu historial es inconsistente.
- Un círculo virtuoso. Las estimaciones son tan buenas como las horas imputadas. Los equipos que registran el tiempo con cuidado obtienen estimaciones más finas, que mejoran la planificación, lo que hace que merezca la pena mantener el parte de horas al día.
10. Limitaciones
El método hereda las manías de sus datos. Si las tareas se llaman "Desarrollo" sin descripción, hay poco texto con el que comparar. Si las horas se imputan en la tarea equivocada, los vecinos arrastran el error. Los tipos de trabajo totalmente nuevos no tienen vecinos, que es justo lo que te indica la marca de baja confianza. Y kNN estima cuánto tardó el trabajo parecido, no cuánto debería tardar: si un equipo es sistemáticamente lento en algo, la estimación lo reproducirá fielmente.
Conclusión
Estimar bien no necesita un modelo que lo sepa todo. Necesita uno que conozca tu trabajo. Combinando un codificador multilingüe compacto con una de las ideas más antiguas del aprendizaje automático, los vecinos más cercanos, Monton convierte las horas que ya imputas en estimaciones explicables, privadas y que mejoran cada vez que se termina una tarea. En el caso de Bewise, eso supuso estimaciones a la altura de las del propio equipo, y un número para el 60 % de las tareas que nunca lo tuvieron.
Referencias: D. Kahneman y A. Tversky, "Intuitive prediction: biases and corrective procedures" (1979). T. Cover y P. Hart, "Nearest neighbor pattern classification", IEEE Transactions on Information Theory (1967). C. J. Stone, "Consistent nonparametric regression", The Annals of Statistics (1977). L. Wang et al., "Multilingual E5 text embeddings: a technical report" (2024). R. Koenker y G. Bassett, "Regression quantiles", Econometrica (1978).
Preguntas frecuentes
- ¿Cómo estima la IA de Monton el esfuerzo de una tarea?
- Convierte el nombre, el proyecto, la fase, el tipo y la descripción de la tarea en un vector de 384 dimensiones con un modelo de embeddings multilingüe, busca las 10 tareas terminadas más parecidas de tu organización y devuelve la mediana ponderada por similitud de las horas imputadas en ellas, junto con el rango entre los percentiles 25 y 75.
- ¿El modelo se entrena con datos de otras empresas?
- No. El modelo de embeddings es un modelo de lenguaje de uso general que solo convierte texto en vectores. La estimación sale exclusivamente de las tareas terminadas y las horas imputadas de tu organización, y la seguridad a nivel de fila mantiene separados los datos de cada organización.
- ¿Cuántas tareas necesito para que aparezcan estimaciones?
- Al menos 20 tareas terminadas con horas imputadas. Por debajo de esa cifra, Monton muestra un contador de progreso en lugar de un número. Las estimaciones ganan fiabilidad a medida que se terminan más tareas, sin ningún paso de reentrenamiento.
- ¿Qué precisión tiene?
- En Bewise, sobre 936 tareas con una estimación humana real, la estimación kNN quedó a menos del doble de las horas reales el 62 % de las veces, frente al 66 % del equipo, y fue más precisa que el equipo con la tolerancia más estricta de ×1,5 (39 % frente a 34 %). Además, da una estimación para el 60 % de las tareas que nadie estimó.
- ¿Se envía el texto de mis tareas a un proveedor externo de IA?
- No. El modelo de embeddings se ejecuta dentro de los propios servidores de Monton, así que el texto de tus tareas no se envía a una API de IA de terceros para calcular las estimaciones.