
Ogni piano di progetto poggia su una pila di piccole scommesse: questo ticket sono due ore, quello è una giornata. Le persone sono notoriamente scarse in queste scommesse. Kahneman e Tversky l'hanno chiamata fallacia della pianificazione già nel 1979: ci ancoriamo allo scenario migliore e dimentichiamo quanto ci è voluto l'ultima volta per un lavoro simile.
La soluzione ovvia è chiedere a un'IA. Ma un modello linguistico di grandi dimensioni non ha mai visto il tuo team, i tuoi clienti o il tuo codice, quindi qualsiasi numero ti dia è un'ipotesi ben scritta. L'informazione che predice davvero quanto durerà la tua prossima attività è già nei tuoi timesheet: migliaia di attività completate, ognuna con le ore che qualcuno ci ha dedicato davvero.
Per questo abbiamo costruito la stima dell'effort di Monton al contrario. Invece di un modello che genera una risposta, recupera il lavoro più simile che la tua organizzazione ha già svolto e lascia votare quello storico. Sotto il cofano è un classico metodo non parametrico, la regressione k-nearest neighbours (kNN), applicata a moderni embedding di testo.
Punti chiave:
- Impara solo dai tuoi dati. Le stime derivano dalle tue attività completate e dalle tue ore registrate, mai da quelle di altre aziende.
- Non ha una fase di addestramento. kNN è un lazy learner: ogni attività che completi diventa subito un nuovo punto dati.
- È spiegabile. Ogni stima arriva con le attività simili che l'hanno prodotta, così puoi vedere perché.
- È quasi brava quanto il team e copre ciò che il team salta. In Bewise ha eguagliato la precisione umana sulle attività stimate dalle persone e ha dato un numero al 60% delle attività che nessuno aveva stimato.
1. Il problema, formalmente
Ogni attività completata di un'organizzazione ha una descrizione testuale e un valore obiettivo , il totale delle ore registrate su di essa:
dove è l'insieme delle registrazioni di tempo sull'attività e la durata di ciascuna. Otteniamo così uno storico etichettato
e il compito è un problema di regressione supervisionata: dato il testo di una nuova attività , prevedere .
Due proprietà di questi dati condizionano tutto il resto. Primo, è piccolo per gli standard del machine learning: da qualche centinaio a qualche migliaio di attività per organizzazione, troppo poche per fare fine-tuning di un modello per cliente. Secondo, ha una coda pesante: la maggior parte delle attività richiede da una a quattro ore, ma alcune ne richiedono quaranta. Entrambe le cose spingono verso un metodo che non richieda addestramento e sia robusto agli outlier.
2. Dal testo ai vettori: gli embedding
Un kNN ha bisogno di una nozione di distanza, e le distanze hanno bisogno di vettori. Mappiamo ogni attività in un punto di con una funzione di embedding .
Il testo che trasformiamo segue un modello fisso costruito con i campi dell'attività stessa:
query: <nome dell'attività> (<progetto> / <fase> / <tipo>) . <descrizione>
I prefissi dei ticket come TASK-625: vengono rimossi (non dicono nulla sull'effort), l'HTML dell'editor viene ridotto a testo semplice e la descrizione viene limitata a 1.200 caratteri.
L'encoder è multilingual-e5-small, un transformer a 12 strati addestrato con apprendimento contrastivo in modo che testi dal significato simile finiscano vicini, in circa 100 lingue. È importante per i team che scrivono ticket in italiano, inglese e spagnolo nella stessa settimana. L'encoder produce un vettore contestuale per ciascuno dei token; ne facciamo il mean pooling e normalizziamo in L2 il risultato:
Dopo la normalizzazione ogni attività vive sull'ipersfera unitaria . Eseguiamo il modello come grafo ONNX quantizzato int8 all'interno dei nostri server: decine di millisecondi per attività una volta caricato, e il testo delle tue attività non va mai a un'API di IA esterna.
Ogni vettore viene salvato accanto all'attività in Postgres con pgvector, insieme a un hash SHA-256 del testo esatto e del modello, così un'attività viene ritrasformata solo quando il suo testo cambia davvero.
3. Similarità: il coseno sulla sfera unitaria
La similarità tra la nuova attività e un'attività completata è la similarità del coseno:
L'ultimo passaggio è il motivo per cui normalizziamo: con vettori unitari la similarità del coseno è un semplice prodotto scalare, ed è legata direttamente alla distanza euclidea da . Ordinare per similarità più alta e ordinare per distanza più breve sono la stessa cosa.
4. Il vicinato
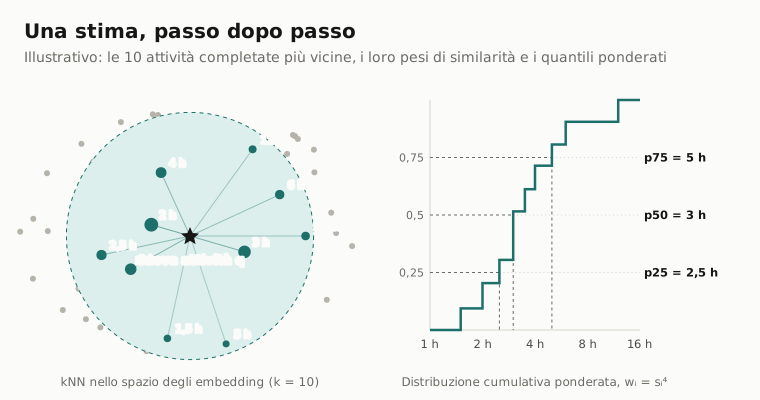
L'insieme dei candidati comprende tutte le attività dell'organizzazione che sono completate, non archiviate, trasformate in vettore e con ore registrate maggiori di zero. L'attività corrente è esclusa, quindi un'attività non può mai "stimare sé stessa". Da quell'insieme teniamo le più simili:
Eseguiamo di proposito una ricerca esatta invece di usare un indice approssimato dei vicini più prossimi (ANN) come HNSW. L'insieme viene filtrato per organizzazione e, con la ricerca ANN filtrata, a un'organizzazione piccola possono restare troppo pochi candidati dopo il filtro, peggiorando il recall senza avvisare. I dati di ogni organizzazione sono abbastanza piccoli perché la ricerca esatta resti veloce, ed è sempre esattamente corretta.
5. Ponderazione: i vicini più vicini votano più forte
Un kNN semplice dà a ogni vicino lo stesso voto. Noi pesiamo ogni vicino con una potenza della sua similarità:
L'esponente esiste per una proprietà nota degli embedding e5: le similarità sono compresse in una fascia stretta, circa tra 0,75 e 1. Sui dati di Bewise, la corrispondenza più vicina di un'attività ha una similarità mediana di 0,937; un quarto delle attività non ne ha nessuna sopra 0,923, e una su dieci nessuna sopra 0,913. In quella fascia le similarità grezze si distinguono a malapena, quindi elevarle alla quarta potenza allarga il contrasto: un vicino a 0,96 riceve peso 0,849, uno a 0,92 riceve 0,716, e il rapporto tra loro passa da 1,04 a 1,19. È un affinamento leggero, una versione morbida della temperatura di una softmax, che favorisce le corrispondenze più vicine senza lasciare che una sola decida tutto.
6. La stima: quantili ponderati, non una media
Il regressore kNN ingenuo è la media ponderata, . Con ore a coda pesante è fragile: un'attività da quaranta ore tra nove da due ore trascina la media a quasi sei ore. Per questo usiamo i quantili ponderati.
Ordiniamo i vicini per ore e costruiamo la funzione di distribuzione cumulativa empirica ponderata:
Il quantile è il più piccolo valore osservato in cui il peso cumulato raggiunge :
Monton ne restituisce tre. La mediana ponderata è la stima puntuale; e formano un intervallo interquartile che indica quanto è variato il lavoro simile.
La mediana non è una scelta arbitraria. È il valore che minimizza l'errore assoluto ponderato e, più in generale, ogni quantile minimizza la pinball loss usata nella regressione quantile:
Con , : la stima è ottimale rispetto all'errore assoluto, che tratta un errore di tre ore come un errore di tre ore invece di elevarlo al quadrato, e ignora l'occasionale mostro da quaranta ore.
7. Sapere quando non fidarsi
Due salvaguardie mantengono onesta la stima:
- Avvio a freddo. Sotto attività completate con ore registrate non c'è alcuna stima. La finestra dell'attività mostra invece un contatore di avanzamento ("12/20").
- Bassa affidabilità. Se anche il vicino più prossimo è lontano, , la stima viene segnalata come a bassa affidabilità. La soglia si trova più o meno al quartile inferiore della similarità della corrispondenza più vicina sui dati reali: in quei casi la tua organizzazione semplicemente non ha mai fatto nulla di simile, e il numero va letto come un riferimento approssimativo.
Cosa vedi in Monton
Nella finestra dell'attività, sotto Effort, Monton mostra la stima IA come mediana e intervallo p25–p75, elenca le attività completate simili su cui si basa con ore registrate e similarità, e offre un pulsante Usa X h per applicarla con un clic. Lo stesso stimatore è disponibile per gli assistenti IA tramite il server MCP di Monton, così puoi chiedere a Claude di stimare un intero elenco di attività mentre prepari una proposta.
8. Caso di successo: Bewise
Bewise è un'azienda di sviluppo software che gestisce progetti, ore e allocazione del team su Monton, quindi era il primo dataset naturale. Al momento dell'analisi contava 5.090 attività completate con 31.178 ore registrate.
Cosa fa davvero il team
Prima di stimare qualsiasi cosa, gli stessi embedding rispondono a una domanda più semplice: che tipo di lavoro riempie le ore? Il nuovo report Analisi delle attività di Monton raggruppa i vettori delle attività in temi. Qui conta un dettaglio tecnico. Poiché il nome del progetto fa parte del testo trasformato, i cluster grezzi raggruppano le attività per progetto anziché per tipo di lavoro. Lo correggiamo centrando ogni vettore sul suo progetto, sottraendo una media del progetto con shrinkage:
dove è il progetto dell'attività e il suo numero di attività. Il fattore di shrinkage evita che i progetti piccoli vengano centrati su una media rumorosa. Poi eseguiamo il k-means, minimizzando la somma dei quadrati all'interno dei cluster
un modello linguistico propone una tassonomia di categorie a singola attività e dà un nome a ogni cluster, e la mappa viene disegnata con lo scaling multidimensionale (MDS) classico dei centroidi, così i temi vicini sulla mappa sono semanticamente vicini nello spazio degli embedding.
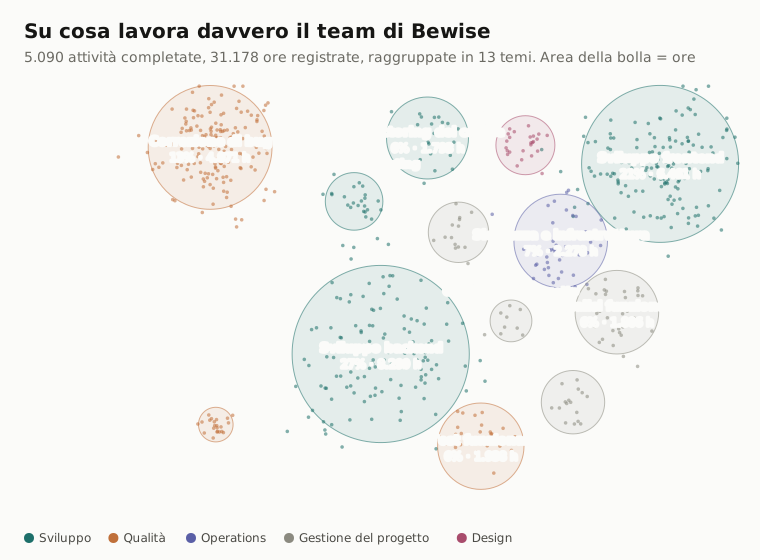
Come prevedibile domina lo sviluppo, ma la mappa mostra anche che la sola correzione di bug vale il 13% di tutte le ore, più di analisi funzionale, documentazione e riunioni messe insieme.
Perché un intervallo e non un solo numero
Lo stesso report mostra quanto varia l'effort all'interno di ogni tema. I box qui sotto sono gli intervalli interquartili delle ore registrate per attività:
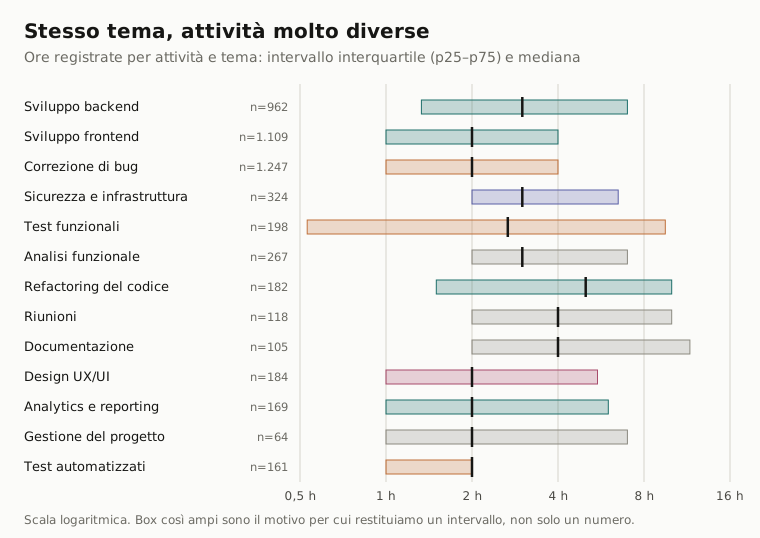
I test funzionali hanno una mediana di 2,7 ore, ma un quarto di queste attività supera le 9,5. Qualsiasi metodo che restituisca un solo numero per "un'attività di test" sbaglierà quasi sempre. Il kNN lavora un livello sotto il tema, sulle dieci attività singole più simili, e riporta comunque la dispersione, così vedi quando lo storico è rumoroso.
Precisione rispetto al team
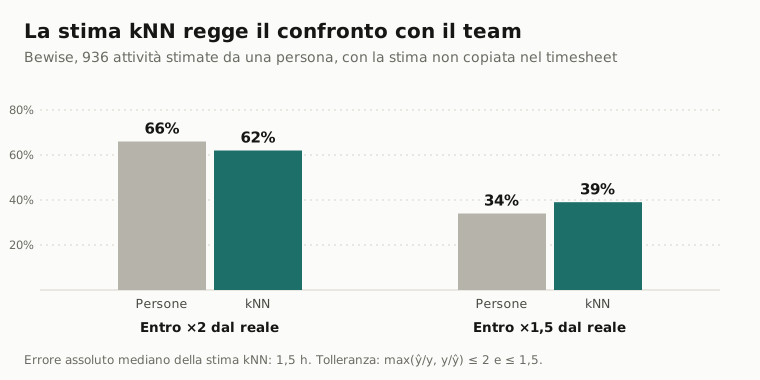
Il confronto con le stime umane nasconde una trappola. Delle attività con una stima umana, 1.077 hanno registrato esattamente le ore stimate: la stima è stata copiata nel timesheet, quindi sembrerebbe perfetta. Le escludiamo e confrontiamo sulle 936 attività in cui una persona ha stimato e le ore registrate sono diverse. Ogni attività viene stimata leave-one-out, a partire da tutte le altre attività completate, esattamente come fa il sistema in produzione.
Contiamo un centro quando la stima è entro un fattore dalla realtà, trattando allo stesso modo sovrastima e sottostima:
| Bewise, attività completate | Attività | Persone entro ×2 | kNN entro ×2 |
|---|---|---|---|
| Stimate davvero da una persona | 936 | 66% | 62% |
| … di cui attività | 877 | 66% | 62% |
| … di cui bug | 53 | 62% | 62% |
| Stima copiata nel timesheet | 1.077 | escluse | escluse |
| Mai stimate da nessuno | 3.077 | nessuna stima | stimate |
I numeri si leggono in tre modi:
- Nella stessa categoria del team. Con la consueta tolleranza ×2, il kNN è quattro punti dietro le persone che conoscono il lavoro, senza impiegare tempo umano.
- Più precisa quando centra. Con ×1,5 batte il team, 39% contro 34%. L'errore assoluto mediano è di 1,5 ore.
- Copre il punto cieco. 3.077 delle 5.090 attività, il 60%, non avevano mai avuto una stima. Per la pianificazione della capacità sono proprio le attività che fanno male, e ora ricevono un numero basato sui dati.
Nemmeno una bassa precisione su una singola attività è sempre un fallimento. Il report elenca le attività che hanno richiesto almeno il triplo delle loro vicine più prossime (524 in Bewise), oppure un terzo o meno (473). Quegli outlier sono i punti in cui lo scope è cresciuto, un ticket è stato usato come contenitore o un problema si è rivelato più difficile del previsto: esattamente le attività da guardare in una retrospettiva.
9. Perché kNN e non un modello più grande?
Fare fine-tuning di un regressore neurale per cliente, o chiedere un numero a un modello linguistico di grandi dimensioni, erano entrambe opzioni sul tavolo. Il kNN ha vinto per proprietà che contano più di qualche punto di accuratezza in un benchmark:
- Si basa sui dati della tua organizzazione, e solo su quelli. Il modello di embedding è generico: sa soltanto che "fix login redirect" e "correggere il redirect del login" significano cose simili. Tutto ciò che decide il numero, il tuo stack, i tuoi clienti, la velocità del tuo team e il modo in cui suddividi il lavoro in attività, viene dal tuo storico. Le stime di un'agenzia che realizza siti WordPress e di una che costruisce backend bancari saranno diverse, com'è giusto.
- Nessuna pipeline di addestramento, nessun drift. Non ci sono pesi da adattare per cliente né riaddestramenti da pianificare. Appena un'attività viene segnata come completata con ore registrate, entra a far parte del modello. La regressione ai vicini più prossimi è uno stimatore consistente ben studiato (Stone, 1977): più storico ha, più vicini sono i vicini che trova, quindi le stime tendono a migliorare da sole con l'uso.
- Spiegabilità per costruzione. La stima di una rete neurale è funzione di milioni di parametri. Quella di un kNN è funzione di dieci attività su cui puoi cliccare. Se il suggerimento sembra sbagliato, l'elenco dei vicini di solito mostra il perché in pochi secondi.
- Privacy e isolamento. La ricerca gira all'interno del database con i permessi di chi la richiede, e la sicurezza a livello di riga limita ogni query a una sola organizzazione. Nessuna attività di un'altra azienda può mai essere vicina delle tue, e il modello di embedding gira sulla nostra infrastruttura.
- Incertezza calibrata a costo zero. Poiché il risultato è una distribuzione e non un punto, l'intervallo p25–p75 non costa nulla in più e si allarga quando il tuo storico è incoerente.
- Un circolo virtuoso. Le stime valgono quanto le ore registrate. I team che tracciano il tempo con cura ottengono stime più precise, che migliorano la pianificazione, il che rende utile tenere aggiornato il timesheet.
10. Limiti
Il metodo eredita i difetti dei suoi dati. Se le attività si chiamano "Sviluppo" senza descrizione, c'è poco testo da confrontare. Se le ore vengono registrate sull'attività sbagliata, i vicini si portano dietro l'errore. I tipi di lavoro del tutto nuovi non hanno vicini, ed è esattamente ciò che segnala l'indicatore di bassa affidabilità. E il kNN stima quanto è durato un lavoro simile, non quanto dovrebbe durare: se un team è sistematicamente lento in qualcosa, la stima lo riprodurrà fedelmente.
In sintesi
Stimare bene non richiede un modello che sappia tutto. Ne richiede uno che conosca il tuo lavoro. Combinando un encoder multilingue compatto con una delle idee più antiche del machine learning, i vicini più prossimi, Monton trasforma le ore che già registri in stime spiegabili, private e che migliorano ogni volta che un'attività viene completata. Nel caso di Bewise, questo ha significato stime alla pari con quelle del team e un numero per il 60% delle attività che non ne avevano mai avuto uno.
Riferimenti: D. Kahneman e A. Tversky, "Intuitive prediction: biases and corrective procedures" (1979). T. Cover e P. Hart, "Nearest neighbor pattern classification", IEEE Transactions on Information Theory (1967). C. J. Stone, "Consistent nonparametric regression", The Annals of Statistics (1977). L. Wang et al., "Multilingual E5 text embeddings: a technical report" (2024). R. Koenker e G. Bassett, "Regression quantiles", Econometrica (1978).
Domande frequenti
- Come stima l'IA di Monton l'effort di un'attività?
- Trasforma nome, progetto, fase, tipo e descrizione dell'attività in un vettore a 384 dimensioni con un modello di embedding multilingue, trova le 10 attività completate più simili nella tua organizzazione e restituisce la mediana, ponderata per similarità, delle ore registrate su di esse, insieme all'intervallo tra il 25° e il 75° percentile.
- Il modello è addestrato sui dati di altre aziende?
- No. Il modello di embedding è un modello linguistico generico che si limita a trasformare il testo in vettori. La stima deriva esclusivamente dalle attività completate e dalle ore registrate della tua organizzazione, e la sicurezza a livello di riga tiene separati i dati di ogni organizzazione.
- Quante attività servono prima che compaiano le stime?
- Almeno 20 attività completate con ore registrate. Sotto questa soglia, Monton mostra un contatore di avanzamento invece di un numero. Le stime diventano più affidabili man mano che si completano altre attività, senza alcun riaddestramento.
- Quanto è precisa?
- In Bewise, su 936 attività con una vera stima umana, la stima kNN è rimasta entro un fattore due dalle ore reali nel 62% dei casi, contro il 66% del team, ed è stata più precisa del team con la tolleranza più stretta di ×1,5 (39% contro 34%). Inoltre fornisce una stima per il 60% delle attività che nessuno aveva stimato.
- Il testo delle mie attività viene inviato a un fornitore di IA esterno?
- No. Il modello di embedding gira all'interno dei server di Monton, quindi il testo delle tue attività non viene inviato a un'API di IA di terze parti per calcolare le stime.